PARCO: Parallel AutoRegressive Models for Multi-Agent Combinatorial Optimization
다중 에이전트 조합 최적화에 쓰는 병렬 자기회귀 모델입니다.
개요 보기 문의
연구와 방법 · 논문
조합 최적화용 강화학습 벤치마크이자 라이브러리입니다.
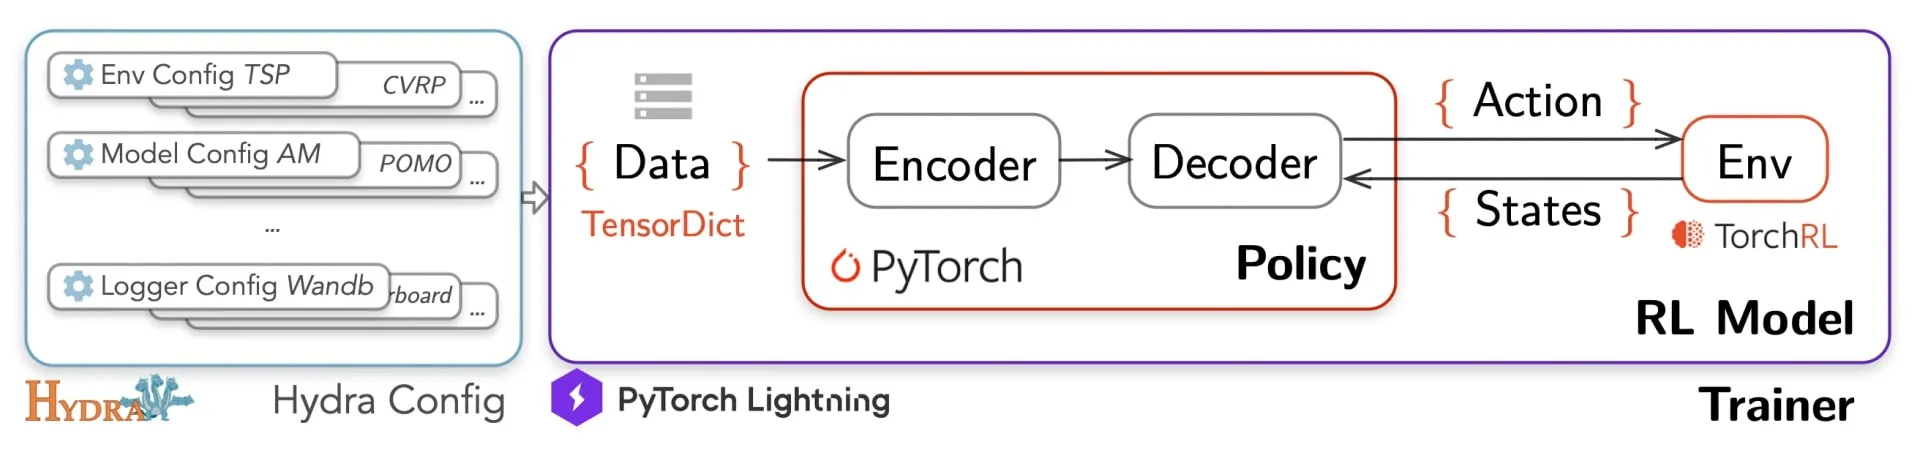
조합 최적화용 강화학습 벤치마크이자 라이브러리입니다.
KDD 2025
Berto, F., Hua, C., Son, J., Kwon, C., and Park, J.