관점
OpenAI의 Strawberry와 omelet의 최적화 AI 서비스 OaaSIS
LinkedIn에 발표한 글을 옮겼습니다. 기술·제품·연구 계획에 관한 설명은 원문 작성 당시의 관점입니다.
OpenAI가 새로운 모델 "Strawberry (o1)"을 출시했습니다. 기존 모델이 방대한 데이터를 활용해 주어진 문맥(text, video, picture)에 대해 가장 높은 확률의 결과를 출력하는 방식으로 학습되었다면, 이번에 출시된 모델은 결과를 도출하는 과정에서 "Search"와 같은 추가 계산(test-time computation)을 통해 복잡한 추론 문제를 해결할 수 있는 것으로 보입니다.
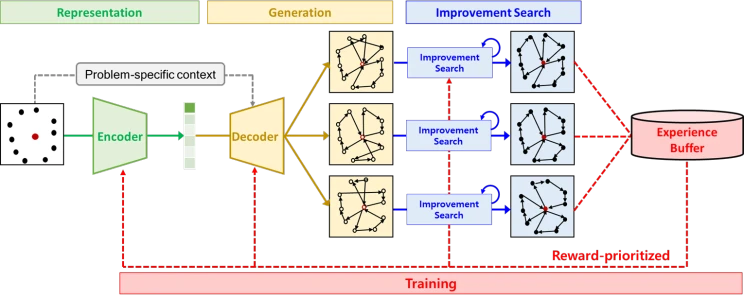
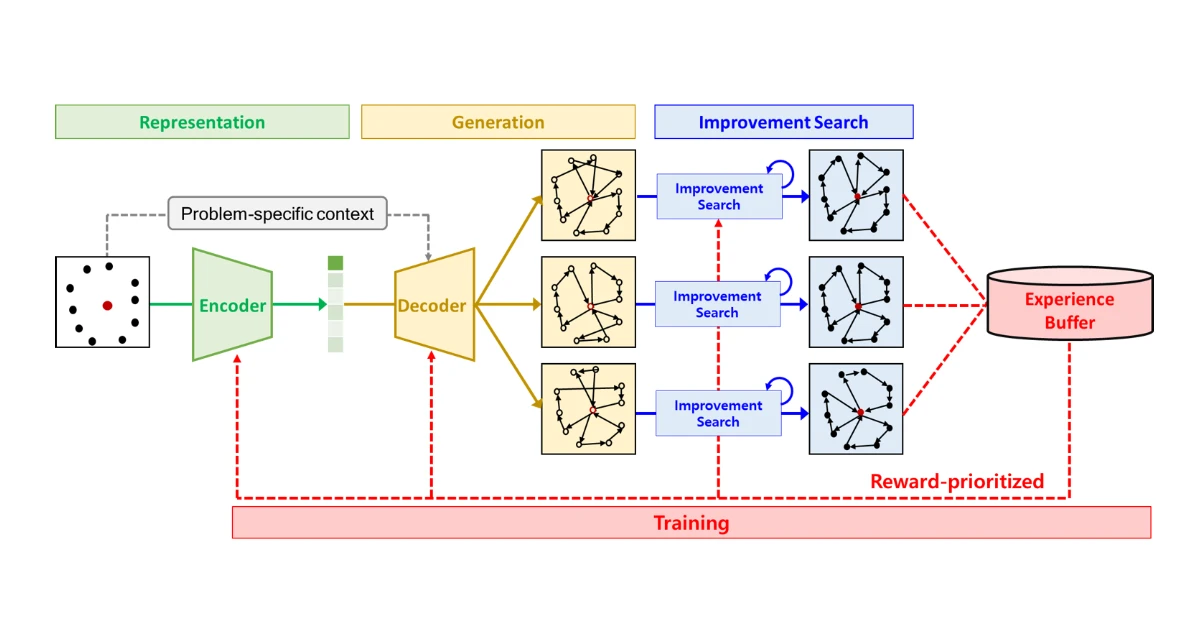
저희 KAIST System Intelligence Lab (www.silab.ac.kr)에서는 오랜 기간 데이터 기반 최적화 및 제어 방법론을 연구해왔습니다. 연구진은 단순히 문제에 대한 최적 해를 예측하는 방식만으로는 복잡한 문제를 해결할 수 없다고 판단하였으며, 순차적 의사결정(Sequential Decision Making) 프레임워크와 검색(Search)을 결합해야 이러한 문제들을 해결할 수 있다고 믿었습니다. 순차적 의사결정 방식은 대상 문제에 대한 해를 실시간 추론(real-time inference)을 통해 효과적으로 구성하고, Search기법은 생성된 해를 점진적으로 개선하여 더 나은 해를 찾아가는 방식입니다. 이 두 과정의 결합은 대규모 학습을 통해 일반적인 선험적 지식을 얻고(Prior), 검색 과정을 통해 특정 문제에 특화된 해를 찾아가는 Bayesian 방식과 유사합니다. 이렇게 도출된 양질의 해는 다시 학습 데이터로 활용될 수 있어, 기존 생성형 모델처럼 방대한 데이터에 의존하지 않고도 유의미한 데이터를 자체적으로 축적하며 점차 진화하는 모델을 만들 수 있습니다. 이를 통해 '데이터 플라이휠(data flywheel)'이 형성되는 것이죠.
이러한 확신을 바탕으로, 저는 2023년에 Changhyun Kwon 교수님(omelet CTO) 및 SILAB 졸업생들과 함께 omelet (www.omelet.ai)을 창업했습니다. 저는 AlphaGo에 적용된 순차적 의사결정 방식에 집중하여 AI가 해를 점진적으로 구성하는 방식을 연구해왔고, Changhyun Kwon CTO는 최적화 문제 해결을 위한 Search 기반 최적화 방식의 전문가였기에 이 두 가지 방법을 인공지능에 결합하면 복잡한 문제를 해결할 수 있는 강력한 최적화 AI가 탄생할 것이라는 확신을 가지고 있었습니다. omelet의 목표는 기업들이 보유한 제한된 데이터로도 최적화된 의사결정을 내릴 수 있도록 인공지능 기반 최적화 서비스, Optimization as a Service/Infra/System(OaaSIS)를 제공하는 것입니다.
사업 초기에는 기존 생성형 AI 모델로는 산업 문제를 해결하기 어렵다는 점을 강조하며, 우리가 복잡하고 다양한 문제를 실제로 해결할 수 있는 인공지능 모델을 개발하고 있다고 설명했을 때 많은 사람들이 회의적인 반응을 보였습니다. 사실 어제까지도 그런 이야기를 해왔습니다. 그러나 이제는 OpenAI의 기존 생성형 AI 모델을 비판하지 않아도 될 것 같습니다. omelet의 OaaSIS는 OpenAI의 Strawberry 모델과 철학을 공유하고 있습니다. 이제 omelet은 더 큰 확신을 가지고 우리가 하던 일에 집중할 수 있을 것입니다. omelet의 OaaSIS를 활용하여 복잡한 문제를 해결할 수 있는 최적화 AI를 구축하고 싶으신 분들은 저희에게 연락 주시기 바랍니다.
jinkyoo.park@omelet.ai